Sweep LLM 功耗控制调度策略研究(二)
前篇文章:https://eduardoqian.com/archives/sweep-llm-gong-hao-kong-zhi-diao-du-ce-lue-yan-jiu-yi 继续书接上回。 PD分离 目前vllm PD分离广泛应用于推理系统中,考虑到prefill和decode的计算特征,
01
前篇文章:https://eduardoqian.com/archives/sweep-llm-gong-hao-kong-zhi-diao-du-ce-lue-yan-jiu-yi 继续书接上回。 PD分离 目前vllm PD分离广泛应用于推理系统中,考虑到prefill和decode的计算特征,
02
8月份了,趁着开学之前,抽时间整理一下暑假做的Reasearch Assistant的工作内容整理。 研究内容 现状 项目主要是基于博士后做的SWEEP-LLM runtime 调度器的进一步扩展。这个调度器尝试解决的问题是在PD分离的异构GPU混合集群上,调度传入请求,使请求能够在满足TTFT/T
03
参考之前的一篇文章,在ideogram 4昙花一现之后,紧接着出现Krea2造成的风浪远远大于ideogram 4. https://eduardoqian.com/archives/t2i-wen-sheng-tu-de-xin-xiu-ideogram-4ti-yan-he-ping-jie h
04
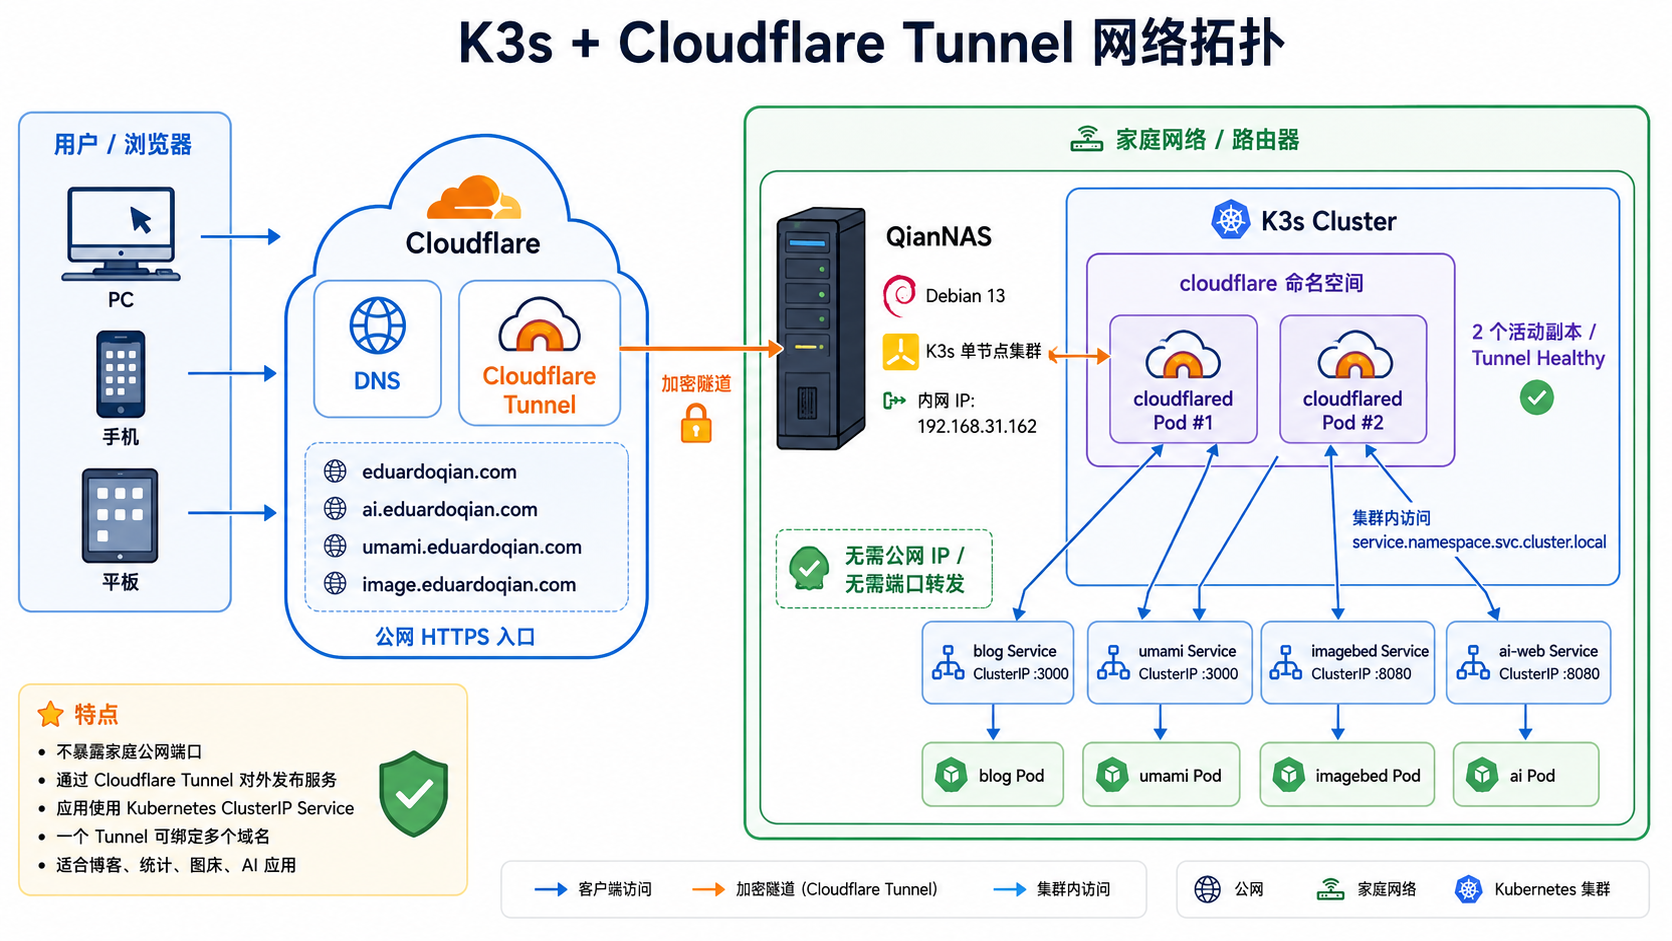
在前段时间在挪威旅游的时候,闲暇时刻就考虑将个人的NAS更换个系统,主要是之前用飞牛的时候,主要考虑的是NAS功能,也就是看下载同步的电影/电视剧/视频等局域网观看。但是在实际用了一段时间后,发现了几个问题: 我个人有些没时间看存到本地的视频了,这些本地视频很难说我是要看,还是纯粹的赛博仓鼠症。 飞
05
考完试后,除了做一些Research Assistant的工作,我惊喜的发现了AI生图开源模型里又来了一个新秀ideogram 4。上一个给我如此惊喜震撼的还是z-image,而细究起来,我对ideogram4的表现以及未来更有信心一些,尤其是考虑到z-image几乎被阿里给砍了,edit模型迟迟不
06
为了加快文档编写速度,我们加快描述。 首先是RMSNorm的实现。我们这里的实现是遍历Embedding_batch中的每个Embedding的Token,对其做RMSNorm的操作: embedding_batch RMSNorm(const embedding_batch &token_embe
07
Tokenizer 概述 下一步是Tokenizer(分词器),Tokenizer是Embedding之前最重要的一步。 它是用来将本文拆分成模型或机器可以处理的小单位,并分配一个唯一的标识符(Token)。 分词流程 分词流程包括Normalization, Pre-tokenization, M
08
在上学期的课程中,我们的任务是对修改后的llama2.c项目(移除了kv-cache和编译器优化)进行优化。因为这个项目强制按组分配,所以我没有机会完整的从头来编写并优化LLM的推理引擎。因此在这里尝试手动从头使用CPU,Naive CUDA Kernel,写一个Qwen的推理引擎。 在这里我们首先
09
目前我已经将原先运行在Racknerd上的Halo博客服务迁移到了本地的机器。 机器是春节回国的时候,从国内拿回来的。是一个G3900的mini-PC,我换了风扇,手动加上了16G内存条,256G的SSD。硬盘是外接的双盘位硬盘盒。 瑞典这里公寓的价格包含了电费,同时也有上下行对等的1000M宽度,
10
Instruction Scheduling Techniques Statically Scheduled Pipelines Out-of-order Instruction Completion In the 5-stage pipeline all instructions start an