罗马-佛罗伦萨-梵蒂冈之旅(二)
在罗马暴走了一天之后,我第二天上午,我吃完酒店的自助餐,因为只有一上午的时间,我去了威尼托街附近闲逛,目的主要是在那附近的嘉布遣兄弟会博物馆和人骨教堂。早上去的时间早,就在威尼托街附近逛了逛。这里的感觉和火车站附近完全不一样,更有“欧洲街道”的感觉,附近是美国大使馆,外交区。相比于火车站,两边是林荫
00 · 文章
01
在罗马暴走了一天之后,我第二天上午,我吃完酒店的自助餐,因为只有一上午的时间,我去了威尼托街附近闲逛,目的主要是在那附近的嘉布遣兄弟会博物馆和人骨教堂。早上去的时间早,就在威尼托街附近逛了逛。这里的感觉和火车站附近完全不一样,更有“欧洲街道”的感觉,附近是美国大使馆,外交区。相比于火车站,两边是林荫
02
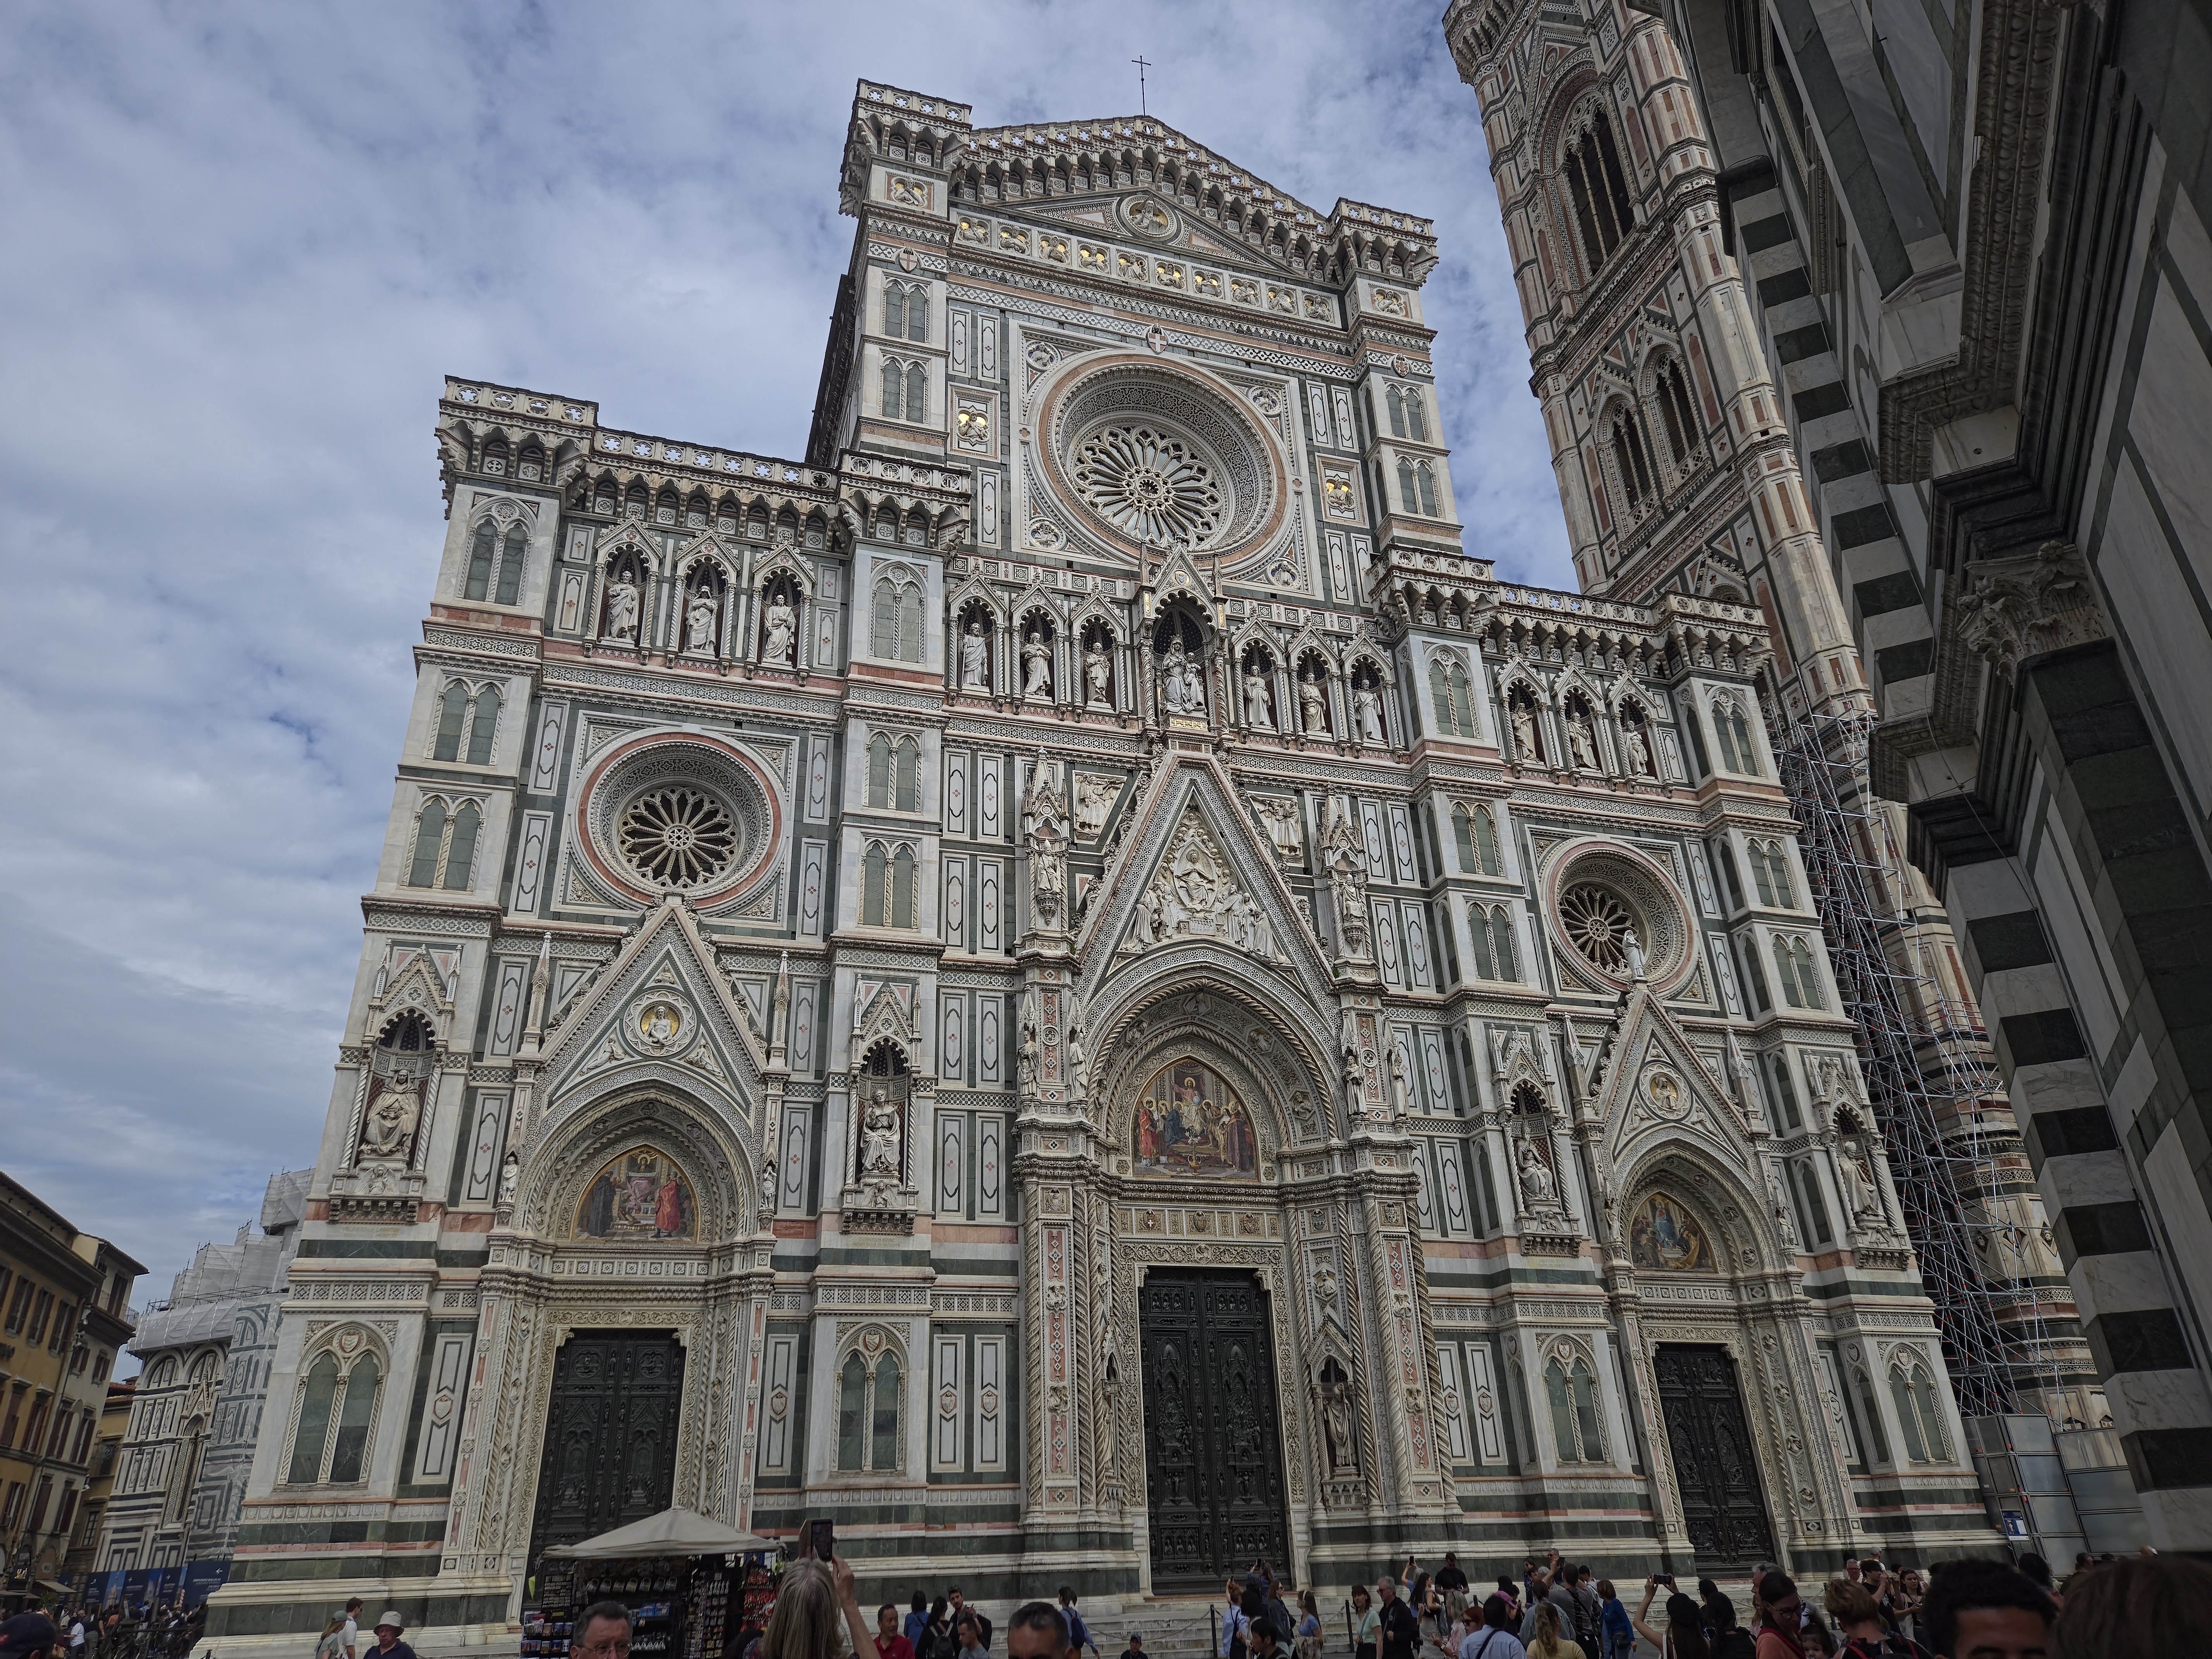
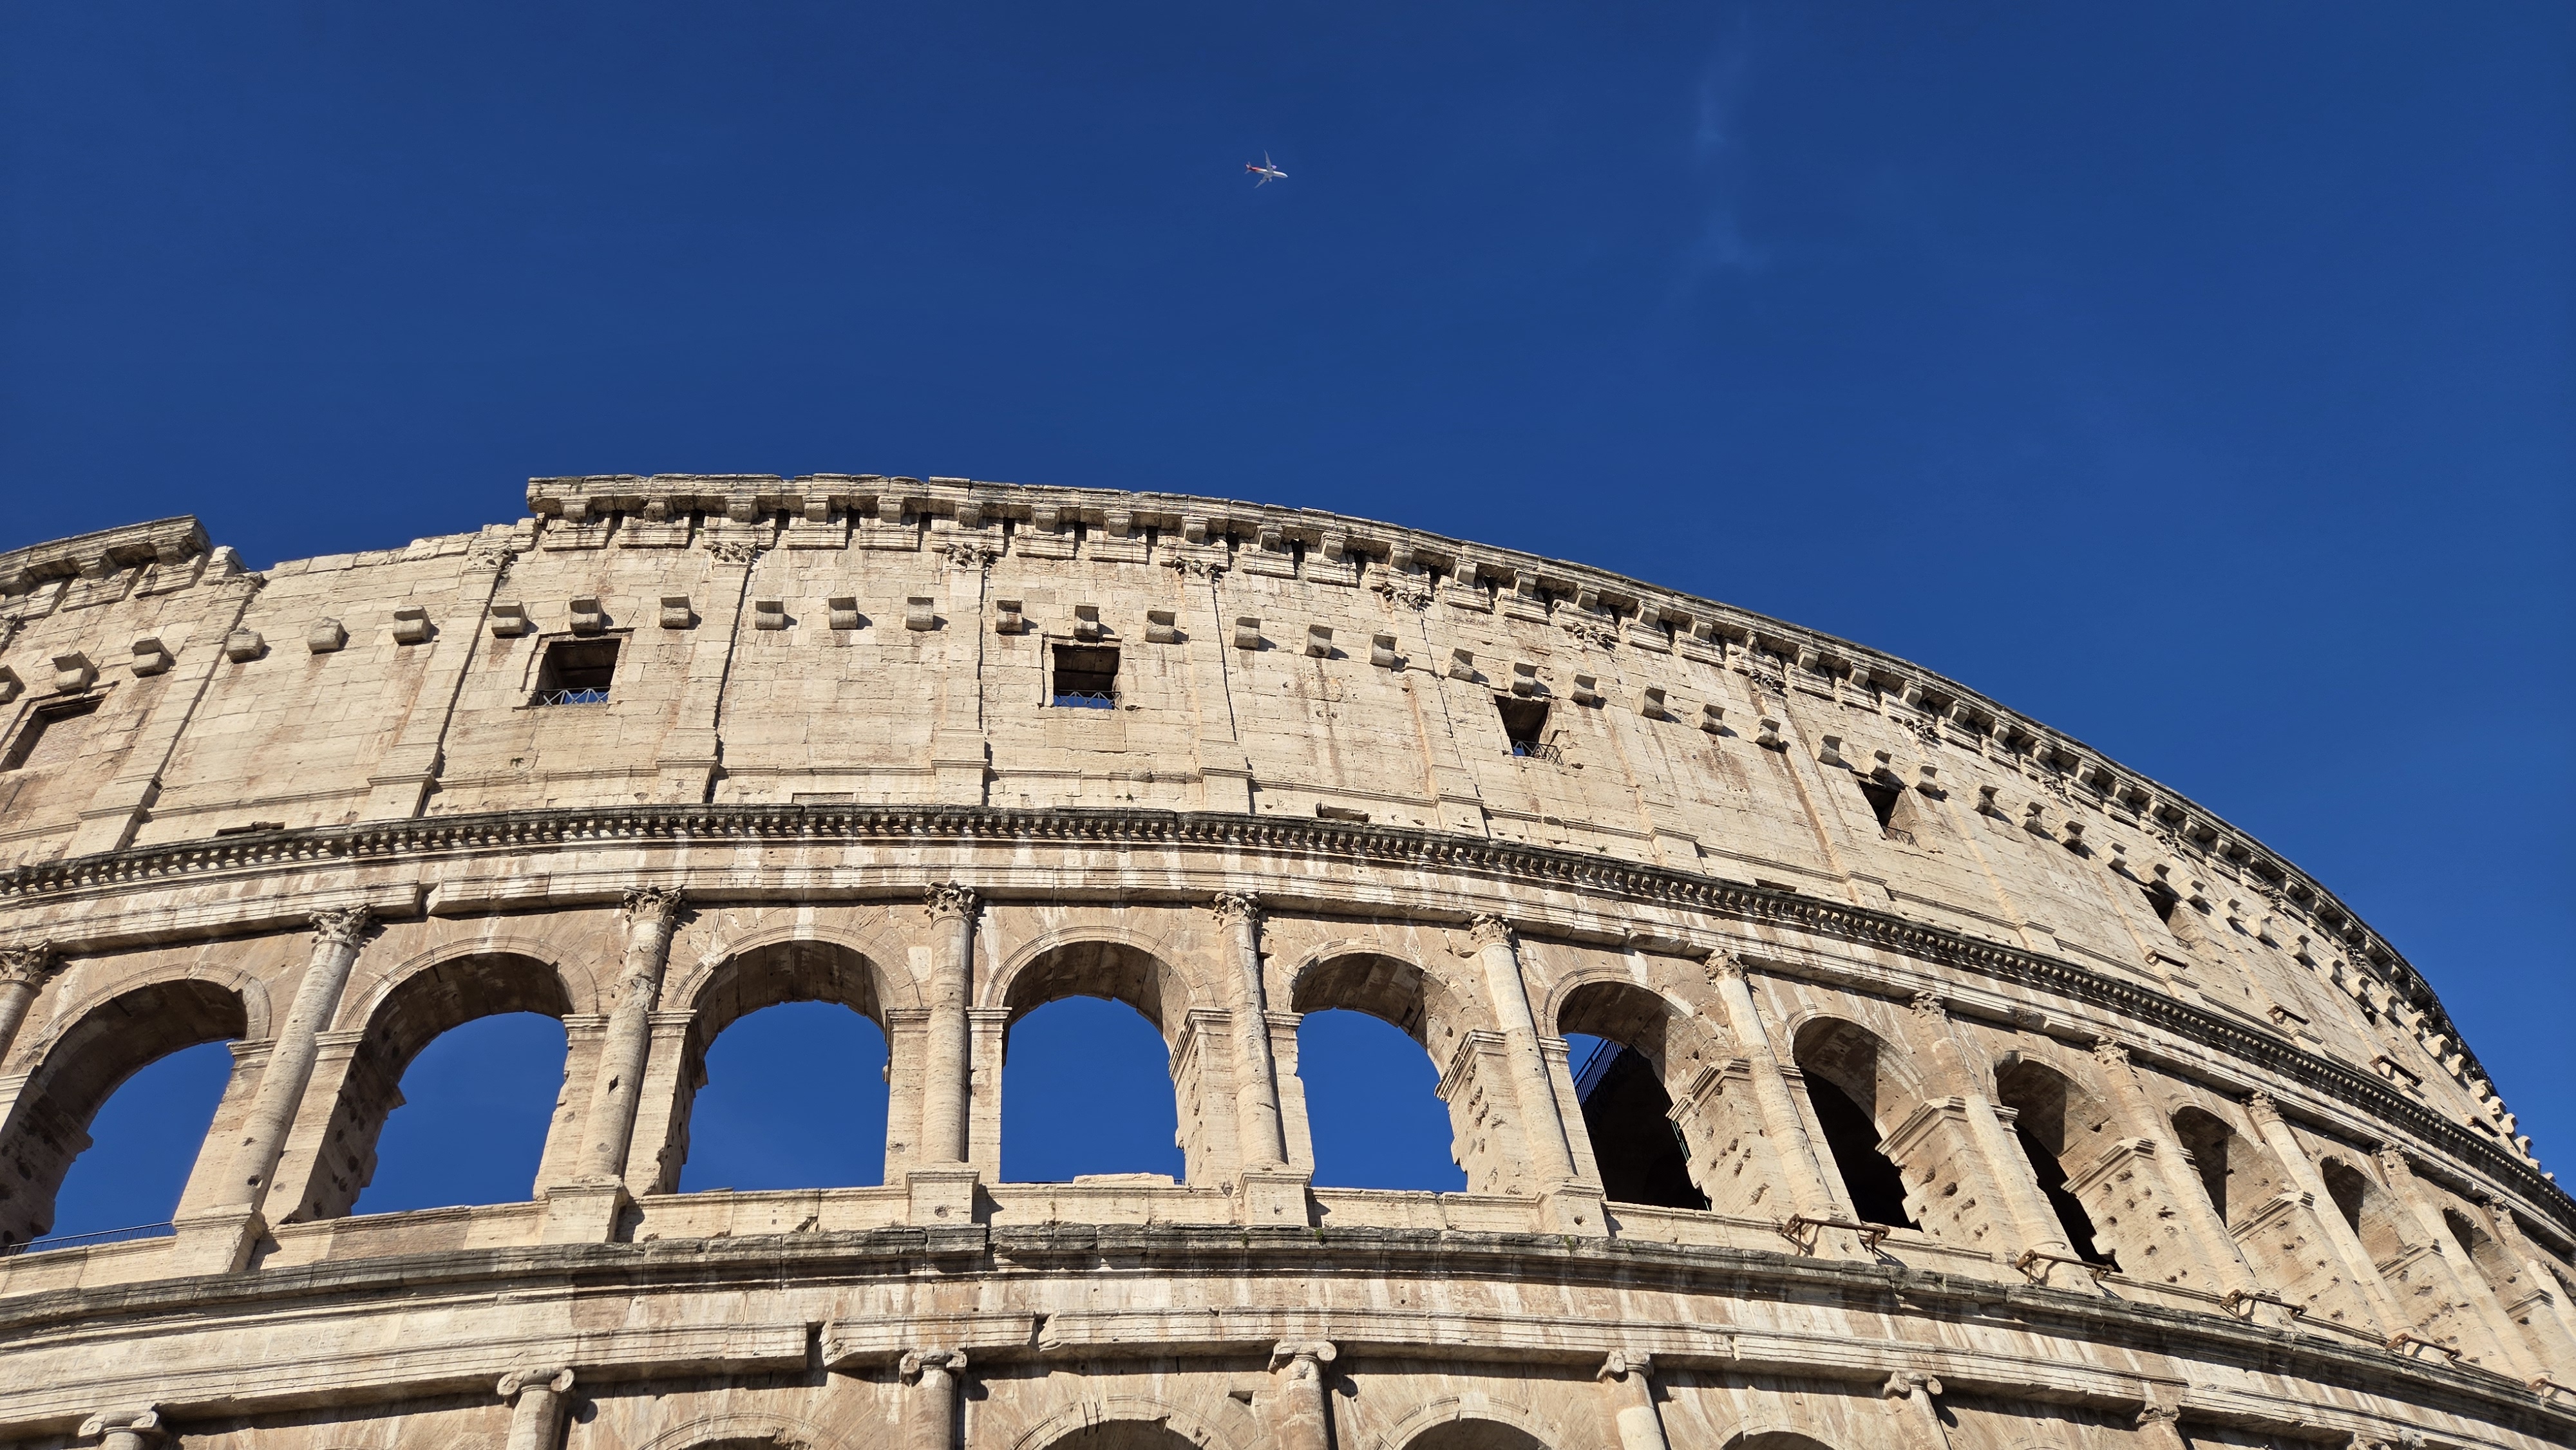
在5月2日——5月7日,我独自前往罗马,开启五天的旅途。 前往罗马的动机其实没有什么特别的,来了瑞典有了将近一年,却没出过瑞典旅游。到了4月下旬时,天气转暖,搜了一下瑞安的航班,发现从哥德堡直飞罗马的飞机往返仅需不到1000元,这个价格正合适,且最近的学习压力也没那么大,于是就定了到罗马的机票,美中
03
从4月2日到4月10日是复活节假期,不巧的是在复活节前期,从海边来了不小的狂风大雨。于是在狂风结束的第二天,我就启程前往了位于城市西边的群岛上进行游览。 我一开始打算徒步的更南侧的Vrångö岛,但是不巧的是到码头的时候,前往Vrångö岛的轮渡还要等将近40分钟,于是临时调转方向前往了最大的岛St

04
为了加快文档编写速度,我们加快描述。 首先是RMSNorm的实现。我们这里的实现是遍历Embedding_batch中的每个Embedding的Token,对其做RMSNorm的操作: embedding_batch RMSNorm(const embedding_batch &token_embe

05
Tokenizer 概述 下一步是Tokenizer(分词器),Tokenizer是Embedding之前最重要的一步。 它是用来将本文拆分成模型或机器可以处理的小单位,并分配一个唯一的标识符(Token)。 分词流程 分词流程包括Normalization, Pre-tokenization, M

06
在上学期的课程中,我们的任务是对修改后的llama2.c项目(移除了kv-cache和编译器优化)进行优化。因为这个项目强制按组分配,所以我没有机会完整的从头来编写并优化LLM的推理引擎。因此在这里尝试手动从头使用CPU,Naive CUDA Kernel,写一个Qwen的推理引擎。 在这里我们首先

07
目前我已经将原先运行在Racknerd上的Halo博客服务迁移到了本地的机器。 机器是春节回国的时候,从国内拿回来的。是一个G3900的mini-PC,我换了风扇,手动加上了16G内存条,256G的SSD。硬盘是外接的双盘位硬盘盒。 瑞典这里公寓的价格包含了电费,同时也有上下行对等的1000M宽度,
08
岁末年关,转眼间又到了2025年底,想起来去年的此时还在边上班边打游戏边等着录取的结果,而现在已经一个人在瑞典边复习边总结,实在是有恍如隔世之感。2025年也注定是我人生中难以忘却的一年,可能到我临死前也仍然会想起今年吧。 痛苦 人是会不断欺骗自己,告诉自己事情还会好的动物,而到了自己也无法欺骗自己

09
本文转载自知乎文章:https://zhuanlan.zhihu.com/p/1943448465209292428 折叠时空—压缩现代性下的中国 写在最前面: 在深入分析之前,我们必须明确一个核心的研究方法论。与可以进行个性化精神分析的个体心理不同,群体心理的研究,始于一个看似反常识却至关重要的前
10
瑞典硕士的学制安排是两个月结束一个小学期,并进行考试,这就意味着现学现考,没什么拖延的机会。这对我这种学习习惯的人来说,是要优于国内本科时那种拉长战线期末冲击好几门的。课程大概在考试前一周就完结了,基本上有完整一个多星期来复习。 这是我从毕业四年以来第一次严格意义的上的“考试”,在这期间只参加过英语
